

它解决了什么
传统的候选人搜索有两个天生的局限:- 只用一个数据库。 合适的人分散在职业社交网络、代码社区、研究平台和公司网站里,单一数据库注定会漏掉一些。
- 只搜一轮。 一次关键词匹配往往返回简历好看的人,而不是真正合适的人。
工作原理
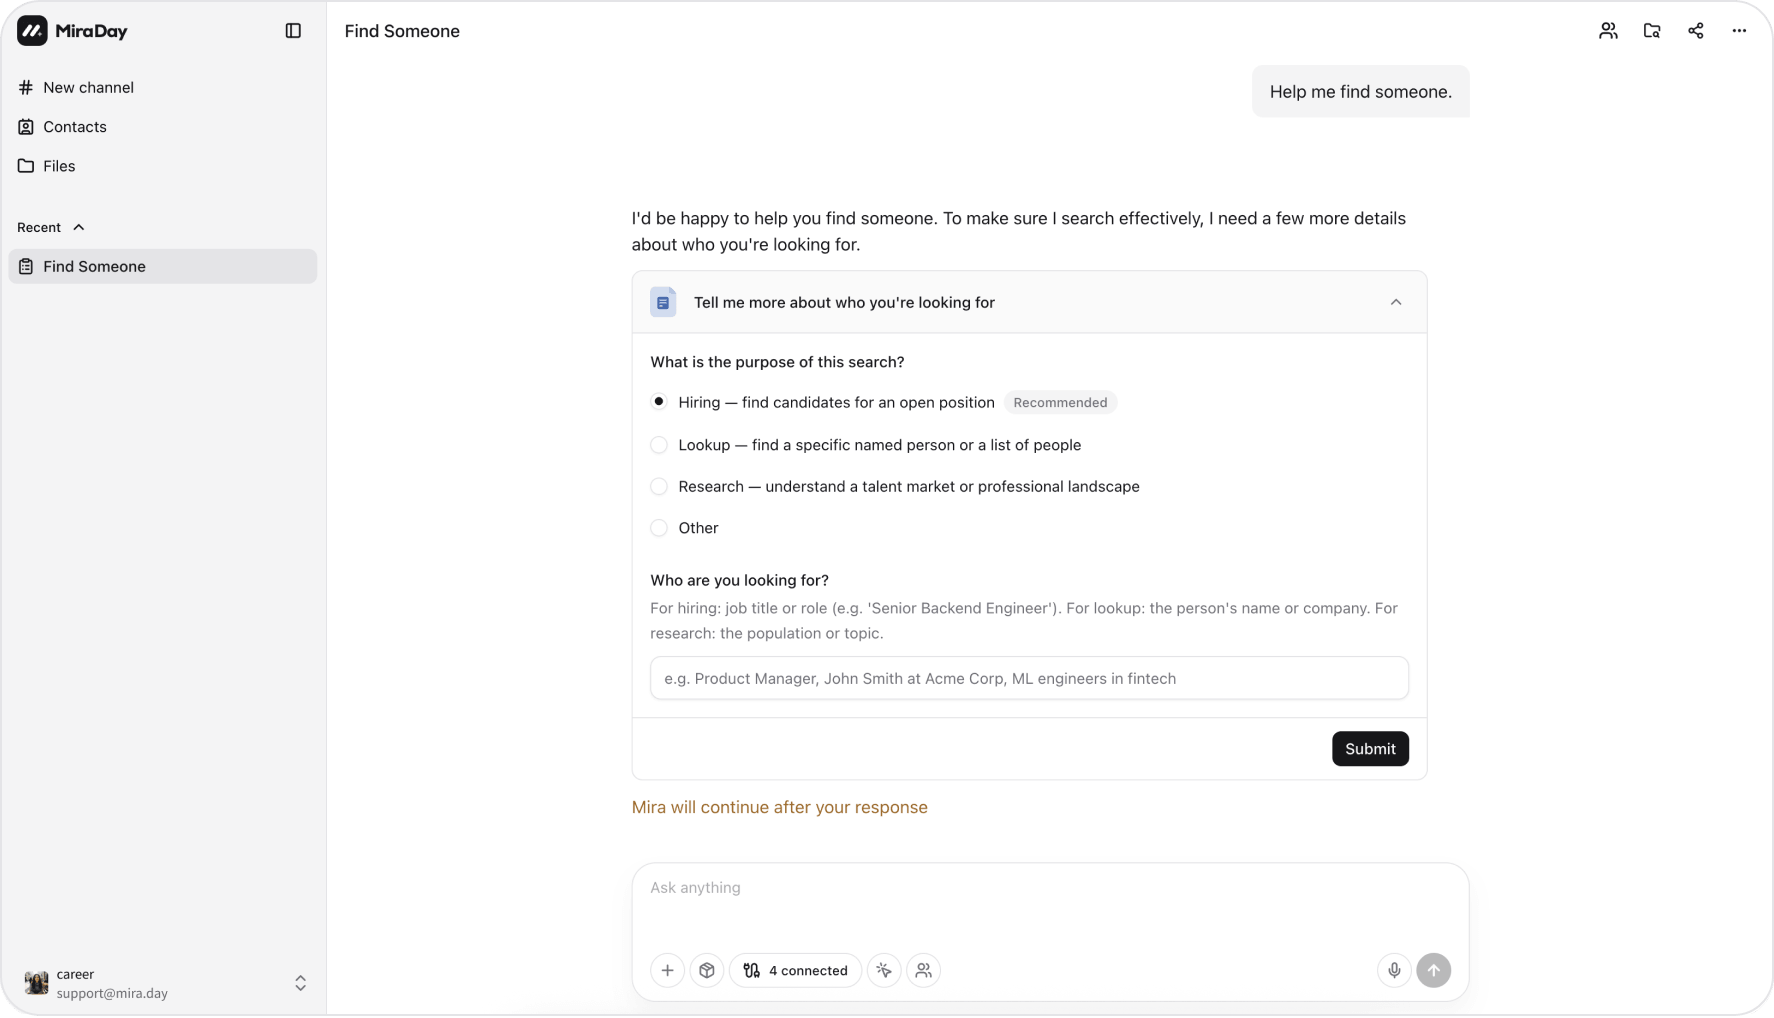
- 你描述需求,用日常语言说清岗位、必备条件和加分项。
- 一个 Sourcing Agent 开始搜索,跨多个人才数据源和公开网络,顺着线索(公司、技术栈、项目、公开作品)深入并交叉验证。
- 你得到可解释的结果:一个候选人池,每个人都附有匹配理由。
- 你来优化。 方向不对就直接说,或加一个条件,Mira 会随之调整。
核心能力
- 多源、多步:公开来源中对应同一人的记录会合并、去重,每一跳都会交叉验证。私有联系人记录与公开来源候选人保持独立,即使对应同一人。由 MRE 驱动。
- 按证据加权的匹配:Mira 会对照你的必备条件和排除项评估每位候选人,并按证据排序,把不明显的人也找出来(比如那位从不更新职位头衔的资深工程师)。每位候选人都带有匹配理由。
- 按需联系方式:找到合适的人之后,可按需查看邮箱或电话(每次查看消耗积分)。
把岗位描述清楚
Mira 能理解自然语言,但上下文越多,Mira 可推理的就越多。弱描述和强描述返回的候选人池差别很大:
平时口头会说的隐含条件,也可以直接写进去。Mira 会理解这些话的意思,而不是当关键词去匹配:
下一步
- 必备条件与排除项:Mira 如何解读你的要求并生成理想人才画像。
- MiraDay 如何匹配候选人:MRE 如何通过推理呈现合适的候选人。
- Agent Team:把一组 Teammate 投入一次复杂搜索。