

它解決了什麼問題
傳統候選人搜尋有兩個內建的限制:- 單一資料庫。 合適的人才分散在職業社群、程式碼社群、研究平台與公司官網,靠單一資料庫注定會遺漏一些人。
- 單次比對。 一次關鍵字匹配往往回傳履歷好看的人,而非真正契合的人。
運作方式
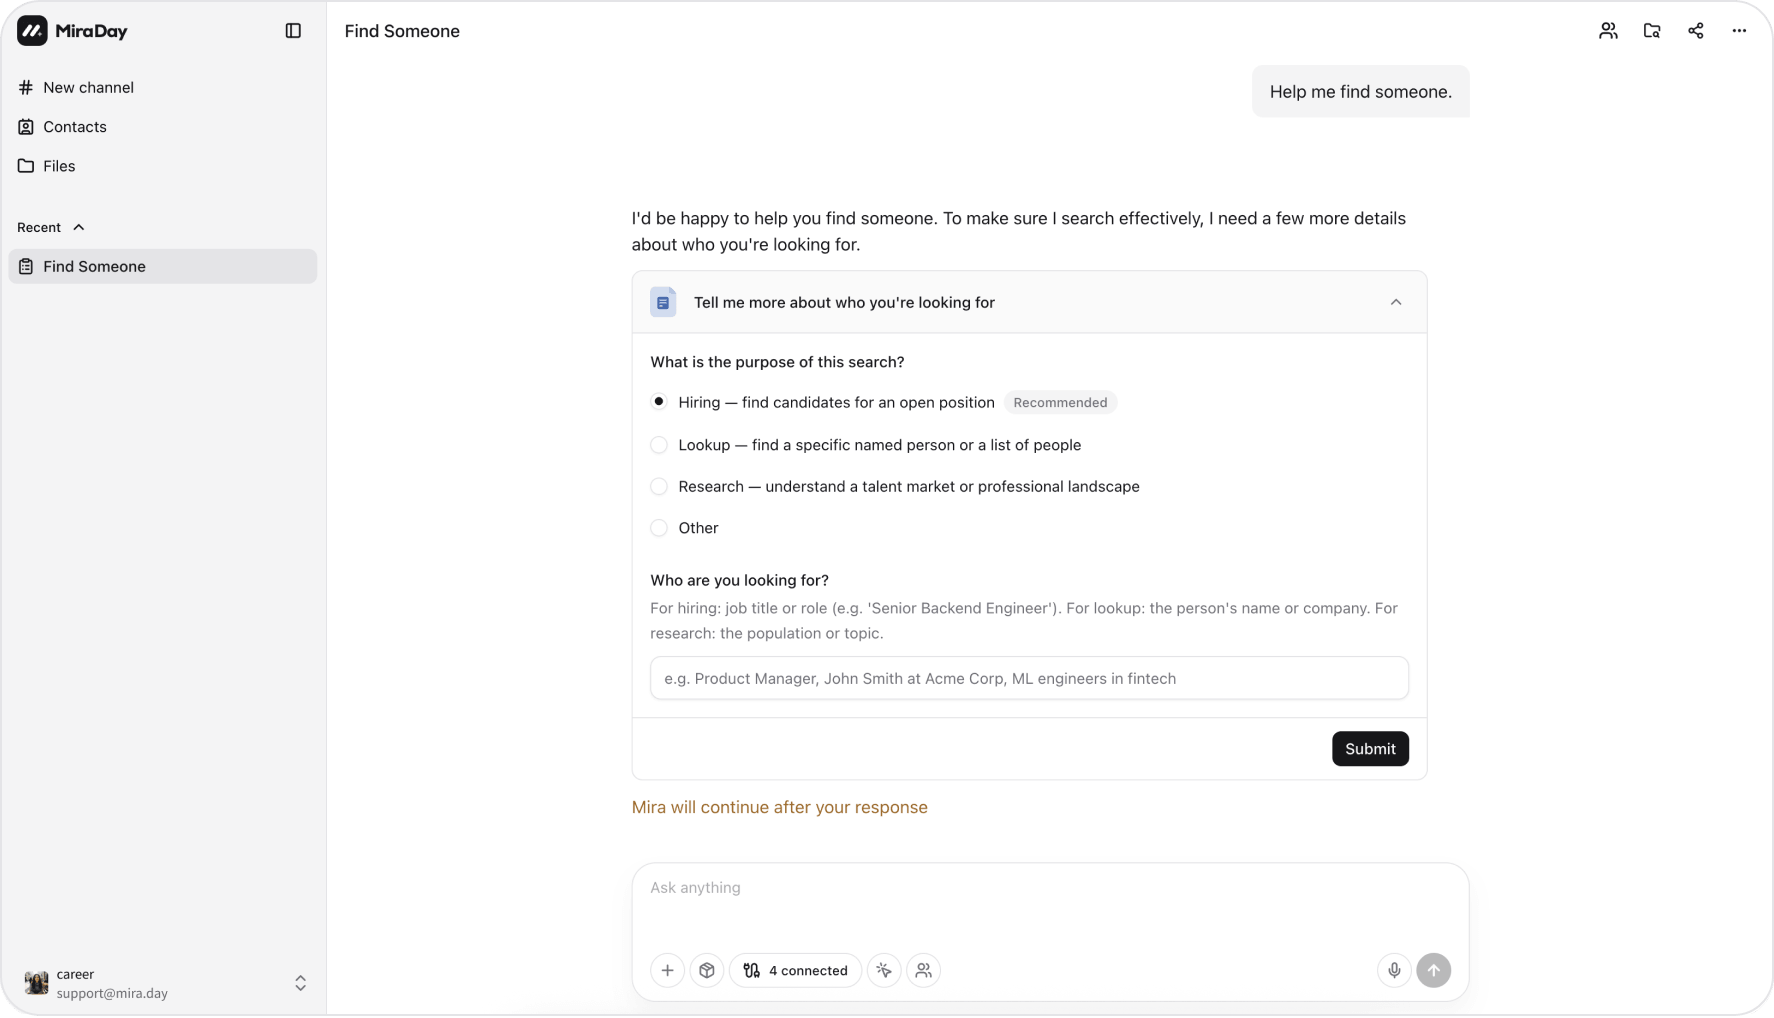
- 由你描述需求,用日常語言說明:職位、必要條件與加分條件。
- 一個 Sourcing Agent 開始搜尋,跨多個人才來源與公開網路,順著 signal(公司、技術棧、專案、公開作品)追蹤並交叉核查。
- 你會拿到可解釋的結果:一個候選人池,其中每個人都附有匹配原因。
- 由你持續精煉。 如果方向偏了,直接說出來或補充一個條件,Mira 就會調整。
核心功能
- 多來源、多步驟:公開來源中相符的紀錄會合併、去重,每一步都會交叉核查。私有聯絡人紀錄與公開來源的候選人會保持獨立,即使是同一個人也不會合併。由 MRE 驅動。
- 以證據加權的匹配:Mira 對照你的必要條件和排除條件評估每位候選人,並依據證據排名,把不易察覺的人才浮出水面(例如那位從未更新職稱的優秀工程師)。每位候選人都附有匹配原因。
- 按需揭示聯絡方式:找到合適的人之後,視需要揭示電子郵件或電話(每次揭示消耗積分)。
把職位描述清楚
Mira 能理解自然語言,但你提供的背景資訊越多,可供推理的素材就越多。弱描述與強描述回傳的候選人池會有很大差距:
你也可以善用那些會直接說出口的隱性條件。Mira 會推理它們的含義,而不是把它們當關鍵字比對:
接下來
- 必要條件與排除條件:Mira 如何解讀你的需求並建構理想人才畫像。
- MiraDay 如何匹配候選人:MRE 如何推理以浮現對的候選人。
- Agent Team:派一支團隊應對複雜搜尋。